

J.A.R.V.I.S.計画 第四十三話
JARVIS型AIエージェントはProxmox VEをどう運用するのか
ノードとVMの監視から、構成バックアップ、更新、メジャーアップグレード、レプリケーション、RAM込みスナップショット、ゲストOS更新、別ノードへの移動まで。JARVIS型AIエージェントが実行できるProxmox VE運用を、実画面と技術手順で整理します。
1. JARVIS型AIエージェントは何を見るのか
Proxmox VEの運用で最初に見るのは、ノード、VM・CT、ストレージ、直近タスクです。AIエージェントは単一の数値だけを見て「正常」「障害」と決めません。現在値、前回差分、その状態が続いた時間、予定作業の有無をそろえてから判断します。
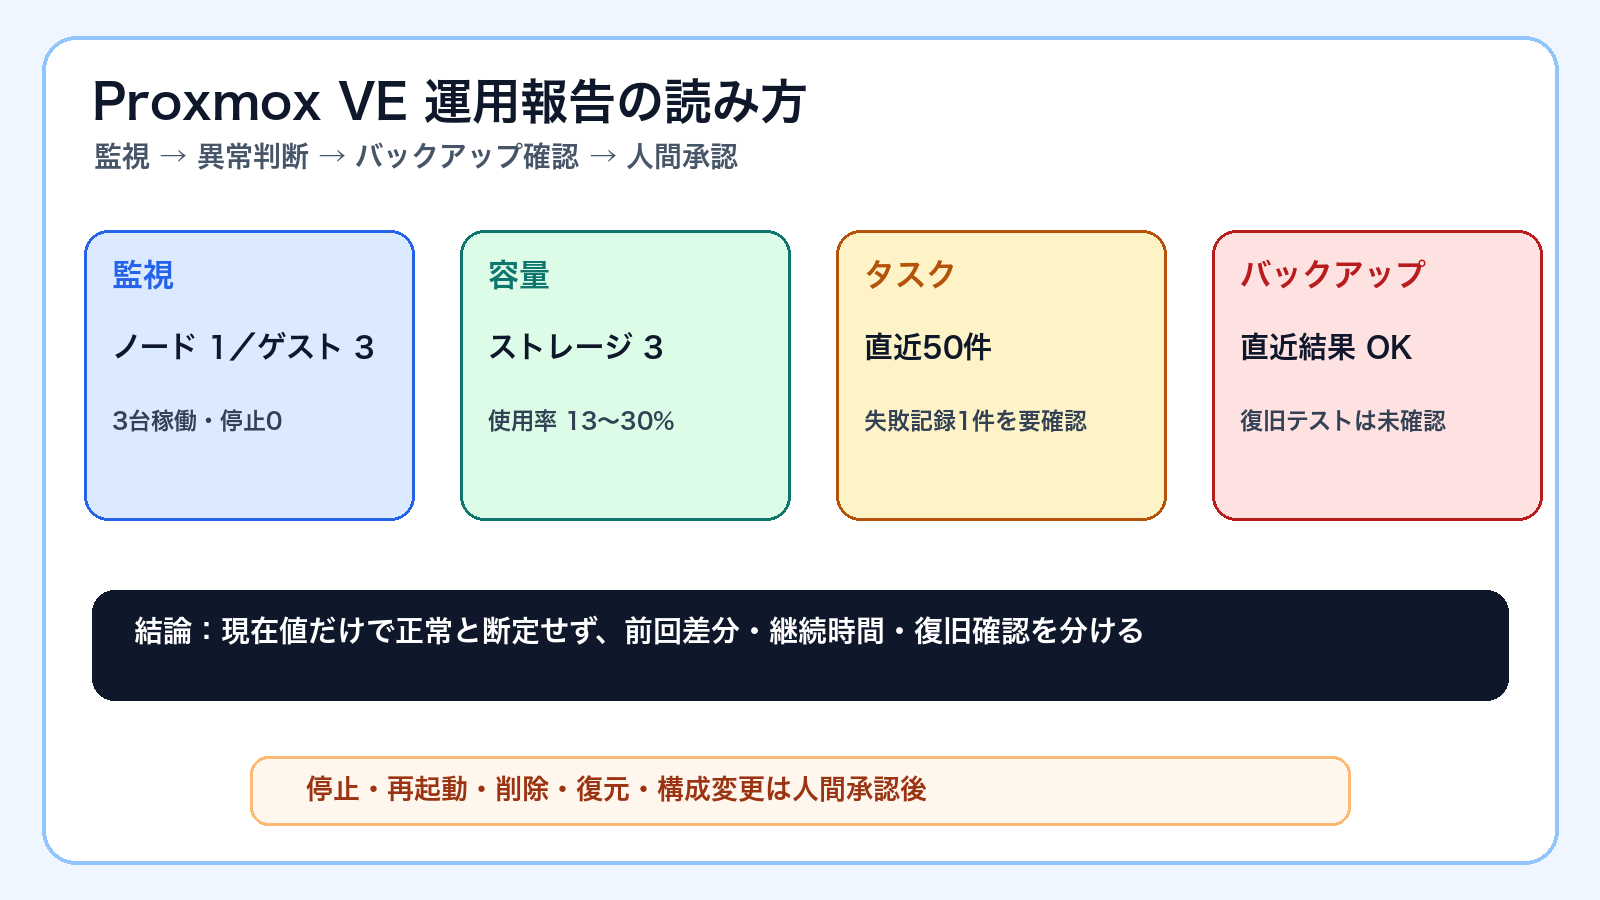
2026年8月18日 10:04 JSTの読み取りでは、ノード1台、ゲスト3台を確認し、ゲストは3台が稼働、停止は0台でした。ストレージは3領域で、使用率は13〜30%でした。公開用画像では、ノード名、VM ID、ストレージ名、ユーザー名などを不可逆マスクしています。
確認できた数値は「その時点の事実」です。正常判定には、前回値と継続時間の照合が必要です。
2. ノードとVMで運用できる範囲
必要なAPI権限、SSH権限、変更承認、切戻し手順がそろえば、AIエージェントは読み取りだけでなく、保護、保守、移動まで一連の運用を担当できます。ただし、「APIで操作できる」ことと「無条件に自動実行してよい」ことは別です。書き込み操作は、対象、影響、事前保護、停止条件を確定してから実行します。
| 対象 | AIエージェントが担当できること | 主な前提・保護 |
|---|---|---|
| ノード監視 | CPU、メモリ、負荷、稼働時間、ストレージ、ネットワーク、サービス、タスク、ログ、バージョンの収集と差分判定 | 読取専用API権限、正常時ベースライン、継続時間 |
| ノード構成バックアップ | クラスター、ネットワーク、ストレージ、権限、APTリポジトリ、ホスト固有設定の収集・暗号化・世代管理・照合 | VMバックアップとは別管理、SHA-256、復元手順 |
| ノード更新 | 更新候補の確認、パッケージ更新、必要時再起動、クラスター・ストレージ・VM復帰確認 | 保守時間、ゲスト保護、1ノードずつ、停止条件 |
| ノードのメジャーアップグレード | 公式事前検査、互換性確認、リポジトリ切替、段階更新、再起動、旧版との差分検品 | 別系統バックアップ、クォーラム、Ceph・PBS・ハードウェア互換性 |
| レプリケーション | ZFS上のVM・CTディスクを別ノードへ定期複製し、遅延、失敗、最終同期時刻を監視 | 複数ノード、ZFS、同一クラスター。バックアップの代替ではない |
| VM監視 | 起動状態、CPU、メモリ、ディスクI/O、ネットワーク、Guest Agent、OS内サービス、更新待ちの確認 | QEMU Guest AgentまたはSSH、サービス別ヘルスチェック |
| 更新前スナップショット | 更新直前の状態をRAM込みで保存し、名前、時刻、説明、空き容量を照合 | 対応ストレージ、アプリ整合性、別途バックアップ |
| VM更新・メジャーアップグレード | ゲストOSとアプリの事前検査、更新、再起動判断、サービス復帰、バージョン確認 | 依存関係、DBスキーマ、停止時間、ロールバック条件 |
| 別ノードへのVM移動 | オンライン/オフライン移行、ローカルディスク転送、移行後のネットワーク・ストレージ・サービス検品 | CPU互換性、ブリッジ名、帯域、共有または移行可能なストレージ |
| 運用記録 | 実行前後の値、変更内容、タスク結果、未確認点、復旧手段を証跡として保存 | 秘密情報の除外、改ざん検知、保存期間 |
「ノードのレプリケーション」は意味を分ける必要があります。Proxmox VEがクラスター内で同期するのは主に設定情報であり、ZFSレプリケーションが複製するのはVM・CTのディスクです。ノードOS、カーネル、全パッケージを丸ごと複製する機能ではありません。
3. 実画面から正常時の基準をそろえる
ノードやゲストが稼働中でも、CPU、メモリ、容量、タスク失敗に変化があれば確認が必要です。反対に、一時的な負荷上昇、予定停止、バックアップ実行中のI/O増加は、障害ではない場合があります。
| 確認対象 | 現在値だけで分かること | 追加で照合すること |
|---|---|---|
| VM・CT | 稼働・停止状態 | 予定停止、直前操作、業務影響 |
| CPU・メモリ | その時点の負荷 | 前回差分、継続時間、処理内容 |
| ストレージ | 使用率 | 増加速度、保存世代、削除予定 |
| Tasks | 成功・失敗履歴 | 対象、再現性、影響、後続確認 |
4. ノード構成バックアップはVMバックアップと別に取る
vzdumpやProxmox Backup Serverで保護できる中心はVM・CTです。ホストが故障したときに同じ構成を再現するには、ノード側の設定とハードウェア・ストレージの台帳も必要です。AIエージェントは、秘密値を除外・暗号化しながら、次の情報を一つの復旧単位として収集できます。
- クラスター設定:
/etc/pve配下のdatacenter、storage、firewall、ユーザー・権限、VM・CT構成。 - ホスト固有設定:ネットワーク、名前解決、APTリポジトリ、カーネル起動設定、時刻同期、証明書運用。
- ストレージ台帳:ZFS pool、LVM、Ceph、マウント、ディスク識別子、容量、健全性。
- 復元根拠:Proxmox VE版、カーネル版、パッケージ一覧、NIC名、IP・VLAN・bridge対応、バックアップのSHA-256。
# 読み取り例。実環境では出力から秘密情報を除外して保存
pveversion -v
pvecm status
pvesm status
ip -br address
zpool status

# /etc/pve はProxmoxの分散設定ファイルシステム
# 稼働中DBを単純コピーするのではなく、検証済み手順で論理的に収集する
バックアップ完了は「ファイルを作った」だけでは判定しません。別媒体または別ホストへ保存できたこと、ハッシュが一致したこと、内容一覧を読めること、機密情報が平文で露出していないこと、復元手順に必要な項目がそろうことまで確認します。
クラスター内の/etc/pve同期は可用性を高めますが、誤変更も同期されます。したがって、クラスター外へ取得する世代バックアップが必要です。
5. ノードのアップデートとメジャーアップグレード
通常アップデートは、同じProxmox VEメジャー版の中で、セキュリティ修正やパッケージ更新を適用する作業です。メジャーアップグレードは、Debian基盤、Proxmox VE、場合によってはCephや周辺コンポーネントの世代をまたぐ変更です。AIエージェントは両者を同じ作業として扱いません。
| 工程 | 通常アップデート | メジャーアップグレード |
|---|---|---|
| 事前検査 | 更新候補、保留、空き容量、クラスター状態 | 公式チェックツール、非互換設定、CPU、Ceph、PBS、リポジトリ、廃止機能 |
| ゲスト保護 | 最新バックアップ確認、必要に応じて移動 | 別系統バックアップ、復元試験、ノード退避、長めの保守時間 |
| 実行単位 | 原則1ノードずつ | 公式の対応順序で1ノードずつ。混在期間の互換性を管理 |
| 完了判定 | 再起動要否、サービス、ストレージ、VM、タスク | 版、クォーラム、全ストレージ、全ネットワーク、移行、バックアップ、HAの代表試験 |
# 事前の読み取り例
pveversion -v
apt update
apt list --upgradable
pvecm status
pvesm status

# 実更新は保守計画・バックアップ・承認後
apt full-upgrade
更新後はコマンドの終了コードだけで完了にしません。新しいカーネルで起動したか、pveproxy・pvedaemon・pvestatd等が稼働しているか、ストレージがactiveか、VM・CTが所定状態か、バックアップや移行が再び動くかをread-backします。クラスターでは、クォーラムを維持したまま一台ずつ進めます。
メジャーアップグレードで、リポジトリだけ先に切り替えて一括更新するのは危険です。対象版の公式手順、事前検査、非互換項目、切戻し可能点を先に固定します。
6. ノード間レプリケーションの正しい意味
Proxmox VEでは、クラスター設定の同期と、VM・CTディスクのZFSレプリケーションを区別します。pmxcfsはCorosyncを使って/etc/pveの設定をクラスター内へ分散します。一方、pvesrが扱うレプリケーションは、ローカルZFS上のゲストディスクを別ノードへ非同期転送する仕組みです。
- 前提:同一Proxmox VEクラスター、複数ノード、送受信側のZFSストレージ、ネットワーク帯域。
- 監視:ジョブ状態、最終成功時刻、転送量、所要時間、遅延、連続失敗、対象ディスク漏れ。
- 用途:計画移行を速くする、障害時の再起動先に直近コピーを持つ、HAの復旧時間を短縮する。
- 限界:非同期なので最終同期後のデータは失われ得る。誤削除や破損も伝播し得る。単独では世代バックアップにならない。
# 読み取り例
pvesr status
pvesr list <VMID>

# ジョブ作成・変更・削除は、対象VM、転送先、間隔、
# RPO、帯域、初回同期容量を確認してから実施する
AIエージェントは、バックアップの最終成功とレプリケーションの最終成功を別々に報告します。レプリカが新しくても復元用の世代がなければ、ランサムウェア、論理破損、誤操作への備えは不足します。
7. 異常確定・要注意・未確認を分ける
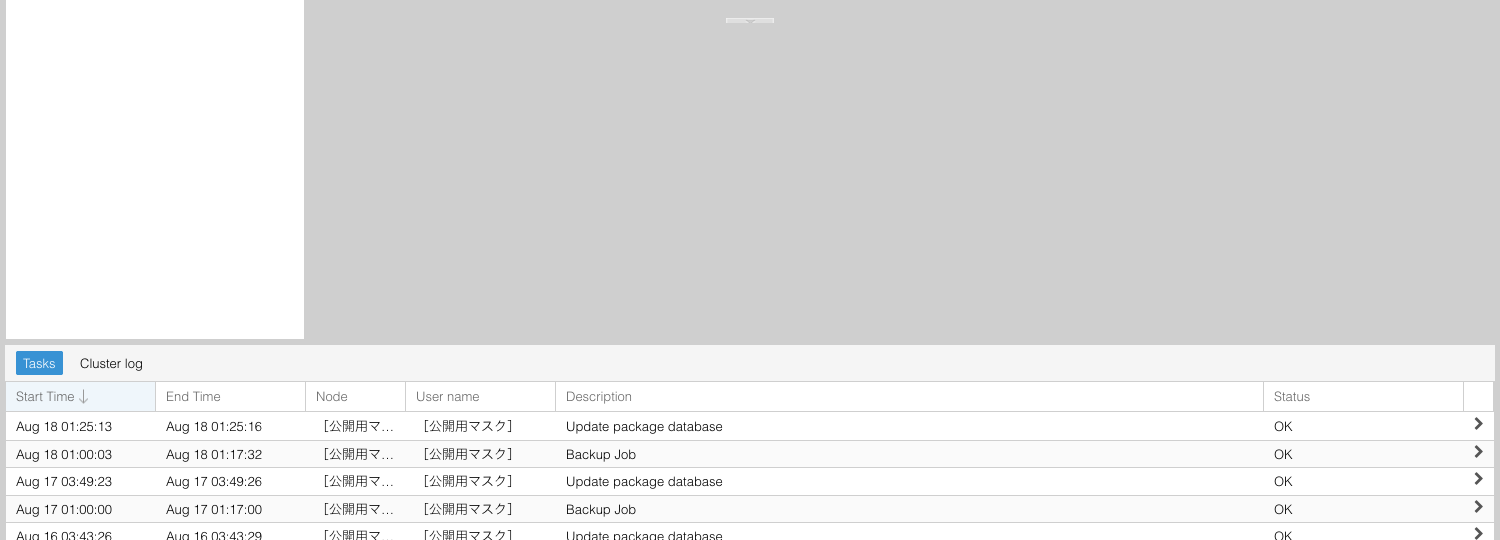
直近タスク50件には失敗記録が1件ありました。ただし、失敗記録が一つあるだけで現在障害中とは断定できません。対象、発生時刻、その後の成功、業務影響を追加確認して、結論を分けます。
- 異常確定:現在も再現し、影響範囲と根拠を確認できた状態。
- 要注意:現在値または履歴に変化があるが、障害と断定する前に追加確認が必要な状態。
- 未確認:権限・画面・証跡が不足し、判断材料がそろっていない状態。
8. VMバックアップと更新前スナップショットを分ける
実画面ではBackup Jobの最新結果がOKで、終了時刻は2026年8月18日 01:17 JSTでした。直近50件の範囲にはバックアップ関連タスクが8件あります。これは「ジョブが成功した」証拠ですが、「実際に復旧できる」ことの証明ではありません。
バックアップは別媒体・別ホストに世代を残し、ホストやストレージを失った場合にも復元するための保護です。スナップショットは、同じストレージ上で更新直前へ短時間で戻すための保護です。更新前は両方の役割を分け、最新バックアップを確認したうえでスナップショットを取得します。
| 保護 | 主目的 | 注意点 |
|---|---|---|
| バックアップ | 別媒体からVM全体を復元 | 成功ログに加え、保存世代、検証、復元試験が必要 |
| ディスクのみsnapshot | 仮想ディスクを直前状態へ戻す | 実行中プロセスやRAM状態は戻らない |
| RAM込みsnapshot | ディスクと実行状態を一体で戻す | 取得時間・容量が増える。対応ストレージと空き容量が必要 |
# ニリアコットの更新前運用例:RAM込みを必須化
qm snapshot <VMID> pre-update-YYYYMMDD-HHMM   --description "guest update precheck completed"   --vmstate 1

# 取得後はsnapshot一覧、作成時刻、vmstate、空き容量をread-backする
qm listsnapshot <VMID>
データベースやメールなど書き込みの多いシステムは、RAM込みだけでアプリケーション整合性が保証されるとは限りません。QEMU Guest Agent、アプリ固有のflush・quiesce、DBバックアップ、停止手順を組み合わせます。また、snapshotを長期間残すとI/Oや容量へ影響するため、更新成功後の削除期限も計画します。
復旧テストの実施有無は、この確認範囲では未確認です。ファイルの存在やジョブ成功だけで復旧可能とは断定しません。
9. VMのアップデートとメジャーアップグレード
Proxmox VE側でVMがrunningでも、ゲストOS内のサービスが正常とは限りません。AIエージェントはQEMU Guest AgentまたはSSHを使い、OS、パッケージ管理、アプリ、DB、監視対象URLまで確認してから更新します。
- 事前確認:OS版、空き容量、更新候補、保留パッケージ、リポジトリ、時刻、バックアップ、サービス状態を記録。
- 保護:最新バックアップを照合し、更新直前のRAM込みsnapshotを取得。DB等はアプリ固有バックアップも確認。
- 更新:Debian/UbuntuのAPT、RHEL系のDNF、openSUSEのZypperなど、ゲストOSに合う標準手順を使用。
- 再起動判断:カーネル、glibc、systemd等の更新と保守条件を見て判断。再起動する場合は停止影響と順序を固定。
- 検品:OS版、更新残件、失敗サービス、待受ポート、HTTP、DNS、メール、DB、ジョブなど、そのVMの役割に合う代表動作を確認。
# Proxmox側の読取例
qm status <VMID>
qm config <VMID>
qm guest cmd <VMID> get-osinfo
qm guest cmd <VMID> network-get-interfaces

# ゲストOS内では、OSに合う更新候補確認とサービス検査を実施
# パッケージ更新はsnapshot取得と承認後に開始する
メジャーアップグレードでは、OSだけでなく、PHP、Python、Java、DB、Webサーバー、監視agent、バックアップagentの対応表を作ります。設定ファイルの自動置換、DBスキーマ変更、廃止暗号、NIC名変更などは切戻しを難しくするため、クローンまたは検証VMで先に再現し、所要時間と失敗点を測ります。
snapshotへ戻せても、外部DB、メール配送、DNS更新、外部APIへの送信など、VM外へ出た副作用までは巻き戻りません。ロールバック判定には外部状態も含めます。
10. VMを別ノードへ安全に移動する
別ノードへの移動は、ノード保守、負荷分散、ストレージ更新、障害回避で使います。共有ストレージ上のVMはメモリ状態を転送するオンライン移行がしやすく、ローカルストレージのVMはディスク転送を伴います。AIエージェントは、移行コマンドを出す前に互換性と移行後の到達性を確認します。
| 確認点 | 技術的な意味 | 不一致時の影響 |
|---|---|---|
| CPU種別・機能 | 移行先で同じ仮想CPU機能を提供できるか | オンライン移行失敗、ゲスト停止、性能差 |
| bridge・VLAN | 同名の接続先とタグが移行先にもあるか | 移行後にネットワーク断 |
| ストレージ | 共有か、ローカルディスク転送が可能か、形式・容量が合うか | 転送不可、容量不足、長時間化 |
| 帯域・収束時間 | メモリ更新量と転送速度が釣り合うか | 切替不能、停止時間増加、他通信への影響 |
| ローカル資源 | PCI passthrough、USB、ローカルISO等の依存がないか | 移行不可、デバイス喪失 |
# 読み取り例
qm config <VMID>
pvesm status
pvesr status

# 実移行の代表形。オプションはストレージ構成に合わせて確定する
qm migrate <VMID> <TARGET_NODE> --online
完了判定は移行タスクのOKだけではありません。VMの所属ノード、起動状態、IP、ARP、DNS、サービス、監視、バックアップジョブ、レプリケーション、HA設定をread-backし、元ノードに残った一時ボリュームやロックも確認します。
11. 監視・更新・移動以外にもできること
Proxmox VE APIとゲスト側の管理経路を組み合わせると、AIエージェントは次の運用も担当できます。重要なのは機能の数ではなく、各操作に権限、事前条件、完了条件、切戻しを割り当てることです。
作成・展開
- VM・CT作成、クローン、テンプレート化
- Cloud-Init、SSH鍵、初期ネットワーク
- CPU・RAM・ディスクの割当と拡張
保護・復旧
- vzdump/PBSバックアップ監視
- 隔離環境への復元試験
- 保存世代、RPO、RTO、暗号化の点検
可用性
- HAグループ・優先ノードの確認
- 障害時再起動とサービス復帰確認
- クォーラム、watchdog、fencing前提の点検
資源・セキュリティ
- ストレージ、bridge、VLAN、firewallの差分監査
- ユーザー、ロール、API tokenの棚卸し
- 証明書期限、更新待ち、監査ログの報告
削除、復元、HAの強制操作、ネットワーク変更、ストレージ縮小、権限変更は影響が大きいため、AIが検査と計画を作り、人が対象と時間を承認した後に実行する範囲です。
12. API・CLI・Guest Agentをどう使い分けるか
JARVIS型AIエージェントは画面の座標を覚えて操作するのではなく、可能な限りProxmox VE REST API、pvesh、qm、pct、pvesrなどの構造化された管理経路を使います。ゲストOS内はQEMU Guest Agentまたは最小権限SSHで確認します。
| 経路 | 得意な処理 | 安全設計 |
|---|---|---|
| REST API/API token | 監視、構成取得、タスク追跡、snapshot、migration等の自動化 | 用途別token、権限分離、期限・失効、秘密値非表示 |
| pvesh/qm/pct/pvesr | ノード上の運用、障害時の診断、明示的なCLI操作 | 固定コマンド、対象ID照合、標準出力と終了コードを保存 |
| QEMU Guest Agent | OS情報、IP、ファイルシステム、shutdown、アプリ整合性補助 | agent稼働とVM設定を確認し、対応コマンドだけ許可 |
| SSH | ゲストOS更新、サービス検査、アプリ固有手順 | 専用鍵、sudo許可コマンド制限、接続先fingerprint確認 |
# REST APIに対応するpveshの読み取り例
pvesh get /cluster/resources --type vm --output-format json
pvesh get /nodes/<NODE>/status --output-format json
pvesh get /nodes/<NODE>/tasks --output-format json

# タスクを起動した場合はUPIDを保存し、終了状態まで追跡する
# HTTP成功だけでなく、タスク終了、実状態、サービス疎通を確認する
監視用tokenと変更用tokenを分ければ、通常時は読み取り権限だけで動かし、承認済み変更の実行時間だけ限定権限を使えます。rootパスワードを常用せず、誰が、何を、いつ実行したかを監査ログへ残せる設計にします。
13. AIが安全に変更するための実行手順
AIエージェントが変更を担当する場合も、いきなり更新コマンドを実行しません。対象を固定し、現在値を取得し、バックアップ・snapshot・移行先などの保護を作り、停止条件を定めてから実行します。
- 対象固定:cluster、node、VMID、storage、実行日時、期待結果を構造化IDで照合。
- 現状取得:version、status、task、capacity、service、前回結果を保存。
- 事前保護:ノード構成バックアップ、VMバックアップ、RAM込みsnapshot、必要に応じて別ノード退避。
- 変更計画:操作、影響、所要時間、停止条件、切戻し、検品項目を提示。
- 段階実行:一台・一工程ずつ実行し、各タスクのUPIDと終了状態を追跡。
- read-back:API値、CLI値、ゲストOS、実サービスの四層で期待結果を確認。
- 報告:確認済み、変更済み、未確認、残件、復旧手段を分けて記録。
通常は読み取りで進める
- Summary・Tasks・Storage・ログの確認
- 前回差分、継続時間、更新候補の整理
- 根拠、影響、未確認点、推奨手順の報告
承認後にAIが実行できる
- ノード・VMの更新、再起動、メジャーアップグレード
- snapshot、レプリケーション、バックアップ、復元
- VM移動、ネットワーク・ストレージ・権限の構成変更
対象不一致、バックアップ未確認、空き容量不足、クォーラム異常、snapshot失敗、タスク失敗、サービス未復帰のいずれかを検知した場合は、次工程へ進まず停止して報告します。
14. 監視結果を人間が判断できる報告へ変える
| 報告項目 | 今回の記載例 |
|---|---|
| 結論 | ゲスト3台稼働、停止0。直近失敗記録1件は要確認。 |
| 確認済み | ストレージ使用率13〜30%、最新Backup JobはOK。 |
| 未確認 | 復旧テストの実施有無、失敗記録の現在影響。 |
| 次の一手 | 失敗タスクの対象と後続成功を照合し、隔離復旧テストの証跡を確認。 |
15. ニリアコットAI特命室で一工程から始める
導入は三段階に分けられます。第一段階は、ノード・VM・ストレージ・タスク・バックアップの読み取りと日次報告。第二段階は、構成バックアップ、更新前snapshot、更新候補整理、移行前検査など、変更前の保護と準備。第三段階は、承認済み手順に沿ったノード/VM更新、メジャーアップグレード、レプリケーション、VM移動、復旧試験です。
既存運用を変えず監視から始め、証跡と停止条件が安定した工程から実行まで広げられます。ニリアコットAI特命室では、単なるアラート転送ではなく、事前確認、保護、実行、read-back、サービス検品、報告までを一つの運用として設計します。
関連するProxmox VE実務記事
Proxmox VE運用をAI特命室へつなぐ
30分AI業務診断で、現在の監視項目、承認点、バックアップ確認、月次報告のどこから始めるか整理します。